Inteligencia Artificial 6 min lectura
2.8 billones de tokens y un pipeline abierto para preentrenar modelos en 22 lenguas indias
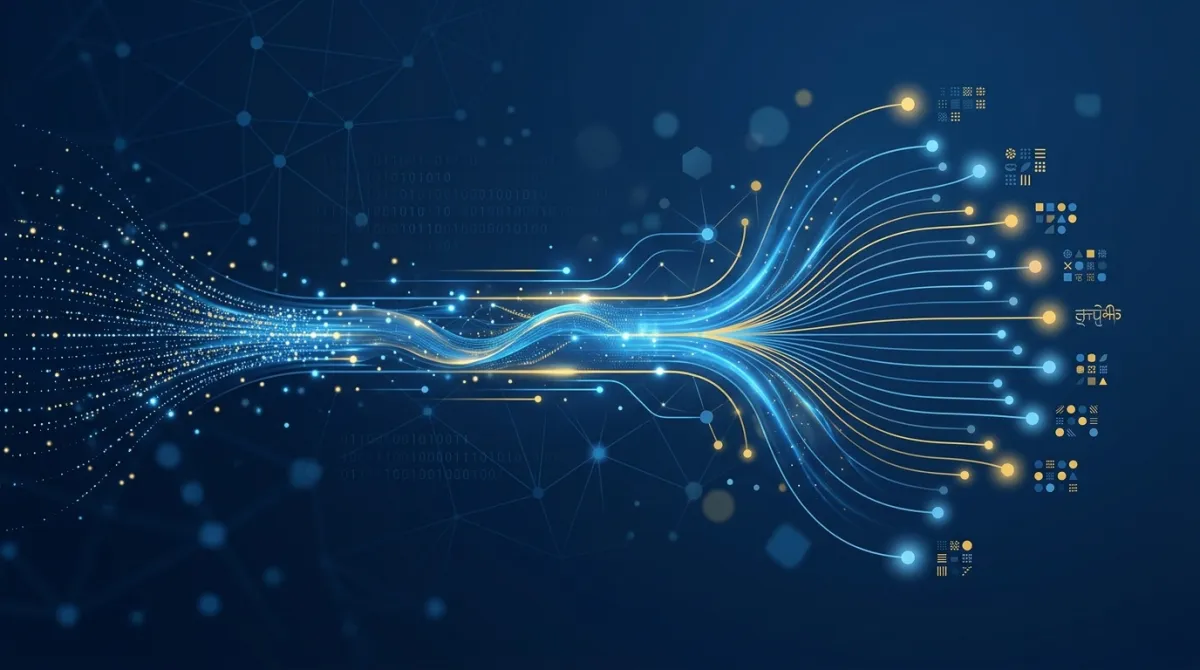
NVIDIA e AI4Bharat liberan Nemotron-pretraining-Indic-v1: un corpus de aproximadamente 2.8 billones de tokens en 22 lenguas indias junto a un pipeline GPU abierto para generación y control de calidad. El material incluye traducciones documentales, preservación de fórmulas y código, y trazabilidad completa.