

Reducir la latencia de LLM en producción con routing consciente de prefijos en SageMaker
Amazon SageMaker ahora puede enrutar solicitudes que comparten el mismo inicio (prefijo) al mismo nodo, permitiendo que las cachés KV se mantengan calientes. Esto reduce significativamente el tiempo hasta el primer token (TTFT) en aplicaciones con prompts compartidos, como chatbots de soporte.
El problema: repetir trabajo en prompts largos
Al construir aplicaciones sobre modelos de lenguaje grandes (LLM), los prompts suelen dividirse en dos partes: un bloque fijo que establece contexto (instrucciones, políticas, historial de conversación, documentos de referencia) y una parte variable con la entrada real del usuario. Un ejemplo típico es un chatbot de atención al cliente: cada solicitud comienza con el mismo bloque de instrucciones y políticas, seguido por la pregunta concreta del usuario.
Cuando ese bloque inicial es extenso —miles de tokens— los frameworks de inferencia que soportan caching, como vLLM o TensorRT-LLM, almacenan las claves y valores (KV) calculados para el prefijo. Así, si el mismo prefijo aparece en solicitudes posteriores, el modelo solo debe procesar los tokens nuevos y puede reutilizar la computación previa, reduciendo el tiempo hasta el primer token (TTFT) y mejorando el rendimiento.
El desafío aparece cuando se escala la inferencia a un clúster de instancias detrás de un endpoint. Si las solicitudes se distribuyen al azar entre las máquinas, ese mismo prefijo largo aterriza en instancias distintas con baja frecuencia por instancia. Ninguna de ellas ve el prefijo lo suficiente como para mantener una caché efectiva, y el beneficio del prefix caching se pierde.
Qué introduce SageMaker: prefix-aware routing
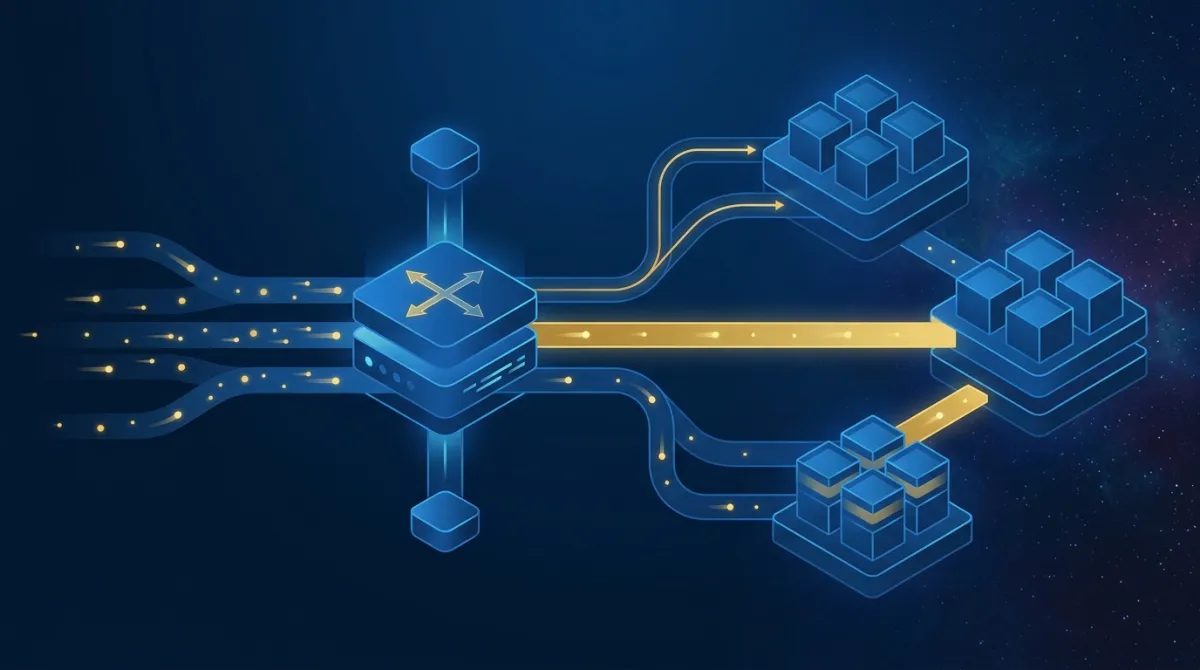
Amazon SageMaker Inference presenta ahora una estrategia de enrutamiento llamada PREFIX_AWARE. Esta lógica inspecciona el comienzo de cada payload y decide a qué instancia enviar la solicitud, de modo que solicitudes con el mismo prefijo lleguen consistentemente a la misma máquina. De esa manera la caché KV de la instancia se “calienta” y las nuevas solicitudes reutilizan la computación previa.
No requieren etiquetar solicitudes ni gestionar afinidad manualmente: el endpoint realiza el enrutamiento según el contenido. Además incluye dos salvaguardas para producción:
-
Protección contra sobrecarga: si un prefijo es extremadamente popular y la instancia objetivo está a capacidad, el endpoint desviará la solicitud a otra instancia menos ocupada respetando el límite de concurrencia configurado. Esto evita saturar una sola máquina, aunque ocasionalmente se pierda un hit de caché.
-
Comportamiento estable al escalar: cuando se añaden o retiran instancias, la mayoría de las solicitudes continúan yendo a la misma instancia; solo una fracción cambia para adaptarse a la nueva flota. Esto evita invalidar cachés cada vez que escala el servicio.
Resultados de rendimiento (benchmarks)
AWS midió el impacto usando Llama 3.1 70B Instruct en 7 instancias ml.p5.48xlarge con vLLM (prefetching habilitado). Se ejecutaron 16 configuraciones de prueba cubriendo endpoints de modelo, endpoints de componentes de inferencia, la API Invoke nativa y la API compatible con OpenAI. Todos los tests completaron con 100% de éxito.
Para cargas de contexto largo (prefijos compartidos de 8,000 tokens, prueba sostenida por 1 hora):
- P90 TTFT: reducción de 33–37%.
- P50 TTFT: reducción de 71–77%.
- KV cache hit rate: aumentó de aproximadamente 25% a 82%.
- Throughput: incremento de 15–16%.
Para cargas de contexto corto (conversaciones estilo ShareGPT, prueba de 30 minutos):
- P90 TTFT: reducción de 24–37%.
- P50 TTFT: reducción de 13–16%.
- KV cache hit rate: aumentó de aproximadamente 30% a 80%.
- Throughput: incremento de 1.7–2.0%.
Como era de esperar, cuanto más largo es el prefijo compartido, mayor el beneficio: hay más computación que evitar gracias a cada cache hit.
Costo en latencia del routing y balance de tráfico
La lógica de routing consciente de prefijos añade entre 1.3 y 1.9 ms por solicitud. En las pruebas, el TTFT del modelo varió entre 63 y 280 ms, por lo que el costo adicional de routing fue despreciable frente al ahorro logrado. Además, el tráfico se mantuvo balanceado: cada una de las 7 instancias recibió entre 13.3% y 15.4% de las solicitudes, sin puntos calientes.
Estrategias de enrutamiento disponibles en SageMaker
Con esta novedad, SageMaker Inference ofrece tres estrategias para endpoints en tiempo real:
-
RANDOM (por defecto): distribución uniforme entre instancias. Adecuada para cargas generales, modelos no-LLM o cuando las solicitudes son intercambiables.
-
LEAST_OUTSTANDING_REQUESTS: envía a la instancia con menos solicitudes en curso. Recomendado cuando los tiempos de procesamiento son variables y se desea evitar que peticiones lentas se acumulen en una sola máquina.
-
PREFIX_AWARE (nuevo): envía solicitudes que comparten el mismo prefijo al mismo nodo. Recomendado para workloads LLM con texto común al inicio y cuando su framework de inferencia soporta prefix caching.
Puede configurar la estrategia por variante de producción en la configuración del endpoint y cambiarla sin redeployar el modelo.
Cuándo considerar usar prefix-aware routing
Esta estrategia entrega valor especialmente cuando sus solicitudes comparten texto inicial repetido: ejemplos claros incluyen bots de atención al cliente con instrucciones y políticas fijas, asistentes con prompt systematizado para cumplimiento, o pipelines que anteponen documentos de referencia largos a preguntas variables.
Si su aplicación tiene prefijos largos y frecuentes, el impacto en P50 TTFT puede ser enorme. Para conversaciones cortas o prompts muy personalizados sin texto compartido, la ventaja será menor aunque aún puede observarse mejora en P90 y en cache hit rates.
Relevancia para equipos y empresas en América Latina
En América Latina, muchos proyectos de IA conversacional se despliegan para atención al cliente, servicios financieros, salud y educación, donde es habitual tener instrucciones regulatorias, políticas corporativas o descriptores de producto repetidos en cada interacción. Mantener calientes las cachés KV en entornos con alto volumen de interacciones puede traducirse en respuestas más ágiles y mejor experiencia de usuario, particularmente en mercados donde la latencia percibida impacta la adopción.
Además, al mejorar el throughput y reducir tiempo de cómputo redundante, las organizaciones pueden optimizar costos operativos asociados a inferencia y dimensionamiento de flotas. Al evaluar esta opción, conviene probar con conjuntos representativos de prompts reales de su región (incluyendo variedad lingüística y formatos locales) para estimar el beneficio exacto.
Consideraciones finales
PREFIX_AWARE es una herramienta práctica para explotar el patrón de prompts compartidos en LLMs distribuidos. Tiene un costo de routing mínimo, medidas para evitar sobrecarga y mantiene estabilidad durante escalado. Para equipos que operan chatbots, asistentes o pipelines con prefijos repetidos, activarla en SageMaker puede ofrecer ganancias notables en latencia y eficiencia.
Antes de activarlo en producción, se recomienda validar con pruebas que representen su carga real y ajustar límites de concurrencia para equilibrar hits de caché y protección contra hotspots.
Fuente original: AWS ML Blog